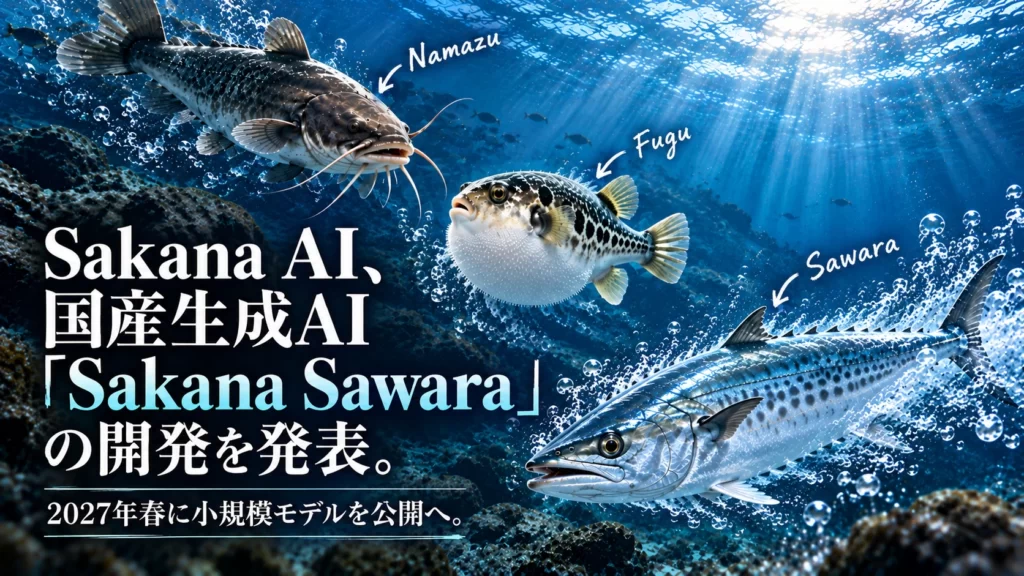
日本のAIスタートアップ企業であるSakana AIは、2026年10月26日、独自の生成AI基盤モデルを開発する新プロジェクト「Sakana Sawara」(仮称)を発表しました。
2026年11月から開発を開始し、2027年春には小規模モデルを公開する予定です。その後は、数千億以上のパラメーターを持つ大規模モデルの開発を目指します。
同社はこれまで、既存のAIモデルを組み合わせる技術を中心に研究開発を進めてきましたが、今回のプロジェクトでは、AIモデルを基礎から構築する事前学習にも本格的に取り組みます。
独自モデルの開発で海外依存の低減を目指す
Sakana Sawaraは、既存のモデルをベースに追加学習を行うのではなく、事前学習1の段階から独自に開発する生成AIモデルです。
現在、高性能な生成AIの開発では米国や中国の企業が先行しており、日本企業が海外製モデルを活用するケースも少なくありません。
一方、海外製モデルへの依存には、提供条件の変更や利用制限、モデルの仕様変更などのリスクがあります。特に防衛やサイバーセキュリティなどの分野では、技術や運用の自主性を確保することが重要です。
Sakana AIは、独自の基盤モデルを開発することで、こうした海外依存の低減を目指します。
また、AIエージェントを活用して事前学習の実験計画や優先順位の決定を効率化し、限られた計算資源でも高性能なモデルを開発できる手法を追求します。
Sakana Namazu・Sakana Fuguとの違い
Sakana AIは、AI開発における「事前学習」「事後学習」「オーケストレーション」の3つを重要な技術領域として位置付けています。
今回発表されたSakana Sawaraは、基盤モデルそのものを開発する事前学習を担当します。
一方、「Sakana Namazu」は、既存のAIモデルに追加学習を実施し、日本語や日本の商習慣などに適応させた大規模言語モデルです。2026年8月には、日本語に特化したLLM APIとして一般提供が開始されました。
「Sakana Fugu」は、複数のAIモデルを連携させるオーケストレーション技術を採用しています。タスクに応じて適切なモデルを活用することで、単一のモデルに依存せず、高度な処理を実現する仕組みです。
Sakana Sawaraは、これらの既存技術を置き換えるものではなく、独自の基盤モデルを開発する新たな取り組みとして位置付けられています。
2027年春の公開を目指す
Sakana Sawaraは2026年10月27日時点では開発計画の段階にあり、一般ユーザーが利用できる状態ではありません。
2027年春に小規模モデルを公開し、その後、より大規模なモデルの開発を進める計画です。
現時点では、具体的なパラメーター数やコンテキストウィンドウ、ベンチマーク性能、API料金、モデルウェイトの公開有無などは明らかになっていません。
今後は、独自の学習手法によってどの程度の性能を実現できるのか、また、日本語処理や専門分野でどのような強みを発揮できるのかが注目されます。
情報元
- 大量の文章やコードなどを使用して、AIに言語や知識の基本的な能力を獲得させる工程のこと。 ↩︎