当ブログでも頻繁に取り上げている「AI」。ここ数年は競争も激化し、各社生成AIモデルの開発スピードが目まぐるしく早くなってきています。
そこで今回は、iPad Air(M4)のAI性能を検証していきます。
GeekBench AI
さて、前回使用した「GeekBench」のAIにより特化したバージョンであるGeekBench AIを使い、CPU、GPU、Neural Engineの性能を試していきます。
3つのスコアの意味
| 項目 | おおまかな意味 | 特徴 |
|---|---|---|
| Single Precision | 32bit浮動小数点(FP32) | 高い精度を保つ一方、演算量・データ量が大きい |
| Half Precision | 16bit浮動小数点(FP16) | 精度をある程度維持しつつ、AI推論を効率化 |
| Quantized | 整数などに量子化したモデル | データを小さくし、高速・省メモリで推論しやすい |
Geekbench AIでは、AI処理を「Single Precision」「Half Precision」「Quantized」という3種類のデータ形式で測定します。
Single Precisionは主に32bit浮動小数点を使用する高精度な演算、Half Precisionは、32bitのSingle Precisionに対して、1つの数値を16bitで表現する浮動小数点形式です。演算やメモリ転送を効率化しやすいため、AI推論でも広く利用されています。一方のQuantizedは、モデルの重みや演算値を低ビット幅の整数などで表現する「量子化」を利用します。Geekbench AIでは、主に8bit整数(int8)を用いたワークロードが測定されます。
一般的にデータの精度を下げるほど処理負荷やメモリ使用量を削減しやすくなるため、Half PrecisionやQuantizedは端末上でAIを実行する際に重要な指標となります。
CPU
まずはCPUをバックエンドに指定して測定しました。
| 項目 | スコア |
|---|---|
| Single Precision | 5,200 |
| Half Precision | 8,554 |
| Quantized | 6,797 |
CPUではHalf Precision Scoreが8,554と最も高く、Single Precisionは5,200、Quantizedは6,797となりました。
CPU単体でもAI処理を実行できますが、後述するGPUやNeural Engineと比較すると、AI処理専用の演算器を利用した場合との差が見えてきます。
GPU
続いて、M4に搭載されているGPUをバックエンドに指定して測定しました。
| 項目 | スコア |
|---|---|
| Single Precision | 10,607 |
| Half Precision | 12,164 |
| Quantized | 10,943 |
GPUではSingle Precisionが10,607となり、CPUの約2倍まで向上しました。
Half PrecisionとQuantizedについてもCPUを上回っており、汎用的な並列演算を得意とするGPUがAI処理でも高い性能を発揮していることが分かります。
特にSingle Precisionでは今回測定した3つのバックエンドの中で最も高いスコアとなりました。
Neural Engine
最後に、AI・機械学習処理に特化したNeural Engineで測定しました。
| 項目 | スコア |
|---|---|
| Single Precision | 5,187 |
| Half Precision | 38,739 |
| Quantized | 54,967 |
Neural Engineでは結果が大きく変わります。
Single Precisionは5,187とCPUとほぼ同等で、GPUを下回りました。一方、Half Precisionでは38,739、Quantizedでは54,967までスコアが上昇しています。
特にQuantized ScoreはGPUの10,943に対して約5倍、CPUの6,797に対して約8.1倍となりました。
この結果から、Neural Engineはすべての演算でCPUやGPUを上回るのではなく、低精度演算や量子化されたAI処理で特に高い性能を発揮することが確認できます。
総合結果
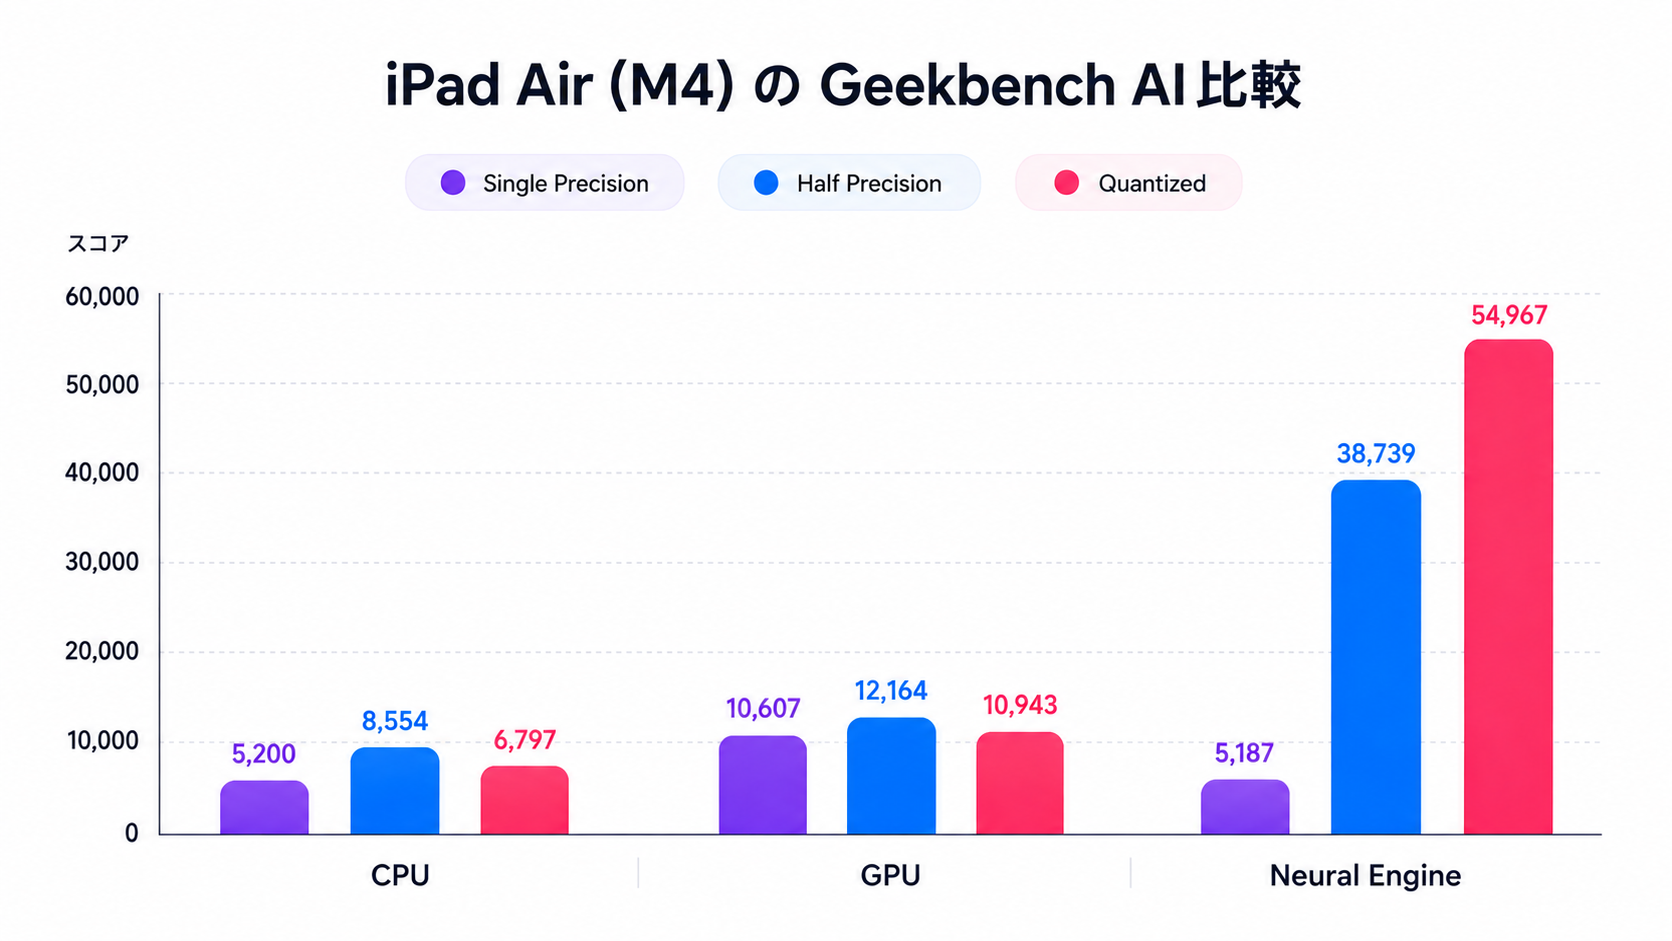
上述のCPU、GPU、Neural Engineのスコアを総括すると上記のグラフになります。
棒グラフで比較すると、Single PrecisionではGPUが最も高い性能を示した一方、Half PrecisionとQuantizedではNeural EngineがCPUとGPUに大きく差をつけ、リードしました。特にQuantizedでは54,967を記録し、GPUの約5倍、CPUの約8.1倍となっています。
Neural Engineは、画像認識や音声処理、自然言語処理など、デバイス上で行われる機械学習処理を高速化するために利用されます。ただし、すべてのAI処理がNeural Engineだけで実行されるわけではありません。AppleのCore MLではCPU、GPU、Neural Engineなどを利用でき、モデルや処理内容に応じて適切な計算ユニットが使用されます。
今回のGeekbench AIでも、Single PrecisionではGPUがNeural Engineを上回った一方、Half PrecisionやQuantizedではNeural Engineが大幅に高いスコアを記録しました。特に低精度・量子化された推論処理でNeural Engineの強みが表れているといえます。
ただし、Geekbench AIは生成AIモデルそのものの文章生成速度を測定するベンチマークではありません。今回の結果は、M4が持つ機械学習処理全般の演算性能を比較したものとして捉える必要があります。
さて今回は、AIベンチマークに主眼をおいてきましたが、次回はローカルAIをiPadで実行すると、どの程度、パフォーマンスを発揮するかについて説明します。