【2026/9/26 お詫びと訂正】
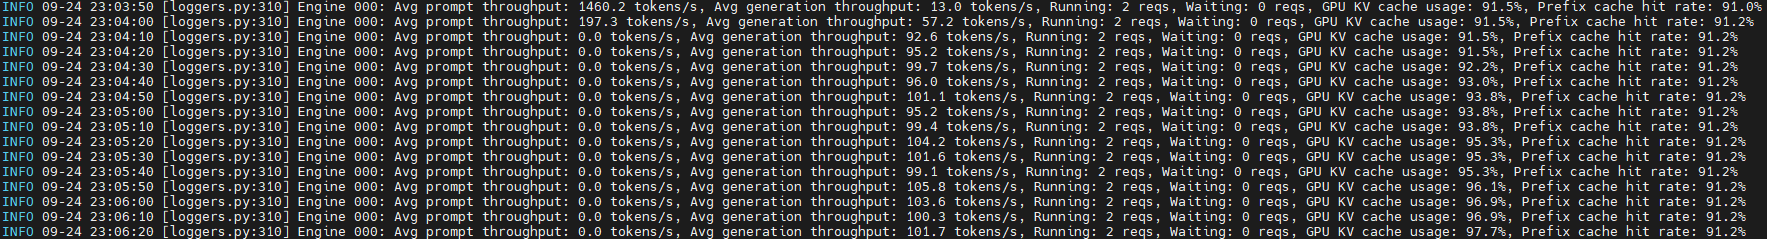
vLLMのprefillが11,000tok/s超と記載しておりましたが、vLLMのログに出るprefill速度はキャッシュ分も含まれているため、大袈裟な値になっています。誤解を与える表現で申し訳ございません。
そのため、リクエスト毎に速度計測&キャッシュを除いたprefillで再算出し、ベンチマーク結果を修正させていただきました。
それに伴い、docker-compose.ymlも更新(キャッシュヒットしたトークン数を出すためのオプションである--enable-prompt-tokens-detailsを追加)しています。
はじめに
筆者はRadeon AI PRO R9700を1枚所持しており、これまでllama.cpp1を使用してQwen3.8-27Bを動かしていました。しかし、llama.cppでは、長いコンテキストを投入するとprefill2が大きなボトルネックになっていました。
例えば、unsloth/Qwen3.8-27B-UD-Q4_K_XL.ggufに約100Kトークンを投入した場合、prefillは処理開始時こそ約1,000t/s3を超えますが、コンテキストが伸びるにつれて徐々に低下し、100Kトークン付近では約350t/sまで落ち、読み込むだけで約5分もかかってしまっていました。
そこで、RDNA4向けの最適化を含むvLLM4フォークであるmagiccodingman/vllm-radianceを導入し、それをR9700 1枚で動作させることに成功しました。実際これが爆速で、prefillが約3倍と大幅な高速化を実現できました。
本記事では、実測結果と、実際の導入手順(.envとCompose5の設定、モデルの取得、16GBメモリ環境向けのモデルの分割、起動)について紹介することとします。
比較について
私が使用したモデルは、llama.cpp側はunsloth/Qwen3.8-27B-UD-Q4_K_XL.gguf、vLLM-Radiance側はamd/Qwen3.8-27B-Quark-AWQ-MXFP4です。ハードウェアとOSは同一ですが、モデルの量子化形式が異なるので、厳密には同条件ではありません。また、本記事のPPとTGはvLLM-Radianceが表示する約10秒単位の区間平均であり、リクエスト全体の通し平均ではありません。つまり、厳密なベンチマークではなく、単に実利用時のログに出た値を記録したものです。
(2026/9/26 訂正) 計測しなおした結果をベンチマーク結果の項に記載しました。
実行環境
| 項目 | 内容 |
|---|---|
| 機種 | MSI Claw A1M-003JP |
| CPU | Intel Core Ultra 5 135H |
| メモリ | 16GB |
| OS | Ubuntu 26.04.1 LTS |
| GPU | AMD Radeon AI PRO R9700 32GB × 1 (電力制限:210W、コアクロック:+15MHz、コア電圧:-75mV、メモリクロック:2820MHzにOC) |
| eGPUドック | MINISFORUM DEG2 |
| 接続 | USB4によるeGPU接続 |
| 推論基盤 | magiccodingman/vllm-radiance |
| 使用時点のコミット | adf9e1f1c9529dd6c971b223a961833376dbd524 |
| モデル | amd/Qwen3.8-27B-Quark-AWQ-MXFP4 |
ベンチマーク結果
計測条件
MTP6を有効にした状態で計測しました。MTPを採用したのには理由がありまして、MTPよりDFlashのほうが生成速度は若干速いのですが、確保できる最大コンテキスト長がMTPの方が大きいからです。具体的には、MTP使用時は約180Kトークンに対し、DFlash使用時は約125Kトークンにまで減少してしまいます。ちなみに、MTP/DFlash無効であれば300K以上の確保が可能です。その他の詳細な設定は、後述の.envおよびdocker-compose.ymlを参照してください。
prefillの計算方法
(2026/9/26 追記)
vLLMログのAvg prompt throughputの値にはキャッシュ分が含まれるため、llama.cppのログの値と直接比較するのはフェアではありません。そのため、リクエスト毎にTTFTや所要時間を計測し、下記の計算式にて算出しています。
vLLMのprefill(t/s) = (入力トークン数 − キャッシュヒットトークン数)÷ TTFT7(秒)計測結果
(2026/9/26 補足・訂正)
vLLMにせよllama.cppにせよ、コンテキストが大きくなるにつれて速度が低下していく傾向があるため、入力コンテキスト別で集計しなおしました。サンプル数が少ないので参考まで。
| 入力コンテキスト | サンプル数 | vLLM prefill平均(t/s) | llama.cpp prefill参考(t/s) | prefillの速度比率 | vLLM decode平均(t/s) |
|---|---|---|---|---|---|
| 0–20K | 6 | 2,241.1 | 1,088.94 | 2.06倍 | 43.0 |
| 20–40K | 29 | 1,813.2 | 620.18 | 2.92倍 | 50.4 |
| 40–60K | 14 | 1,615.4 | 498.42 | 3.24倍 | 52.0 |
| 60–80K | 19 | 1,368.2 | 401.43 | 3.41倍 | 50.3 |
| 80–100K | 11 | 1,255.6 | 344.45 | 3.65倍 | 49.8 |
| 100–120K | 16 | 1,057.0 | 311.41 | 3.39倍 | 50.2 |
| 120–140K | 4 | 762.5 | — | — | 42.2 |
このように、コンテキスト長100K周辺において、vLLMがllama.cppに比べ3倍以上速いのではないか、という結果になりました。
また、decodeの速度も、概ね50t/sを維持しており、感覚的には倍くらい速いか?という印象でした。
なお、vLLMはllama.cppより並列実行に強いため、decodeに関しては並列で処理させることでトータルの速度を稼ぐことができます。参考までに、2並列時は100t/s超という速さが出ているときもありました。3並列以降ではさらに速くなる可能性があります。と言っても上限が180Kでは、並列で動かすにも限度がありますが。
次ページからは実際の導入手順です。
- llama.cppは、ローカル環境でLLMを動かすための軽量な推論エンジン ↩︎
- prefillは、入力した文章全体を処理し、生成に使うKVキャッシュを構築する処理。生成開始前の準備段階。PP(Prompt Processing)とも呼ばれる。また、decodeはText Generation(TG)、つまり生成フェーズを指す。 ↩︎
- t/sは1秒あたりに処理されるトークン数の単位(tokens/s)。 ↩︎
- vLLMは、LLMを高速かつ効率的に動かすための推論エンジン。フォークは、公開されたソフトウェアを派生させて独自に改良したもの ↩︎
- Dockerは、アプリケーションをコンテナと呼ばれる独立した環境で実行する仕組み。Composeは、そのコンテナの設定をファイルにまとめて管理するツール ↩︎
- MTPとDFlashは、いずれも生成を高速化する投機的デコード(speculative decoding)の方式 ↩︎
- Time to first token (TTFT)、モデルが最初のトークンを応答するまでにかかる時間 ↩︎
- Hugging Faceは、AIモデルが公開・配布されているプラットフォーム ↩︎
- ここでのカーネルは、GPU上で実行される演算プログラム。コンパイル結果はキャッシュされるため、2回目以降の起動は短縮される ↩︎