vLLM-Radianceを導入する
GitHubリポジトリを任意の作業ディレクトリへcloneします。以降のコマンドは、clone後のリポジトリ直下で実行する想定で記載します。
git clone https://github.com/magiccodingman/vllm-radiance.git
cd vllm-radiance
mkdir -p models vllm-cache.envを設定する
.envを、次の内容で作成します。.envで指定しないものは、docker-compose.ymlの既定値を使用します。
nano .env# Model
MODEL_PATH=/models/Qwen3.8-27B-Quark-AWQ-MXFP4
# GPU and API
HIP_VISIBLE_DEVICES=0
TP=1
PORT=11434
# Capacity
MAX_MODEL_LEN=180000
MAX_NUM_SEQS=2
MAX_NUM_BATCHED_TOKENS=4096
GPU_UTIL=0.99
# Weight quantization and native MXFP4 W4A8
WEIGHT_QUANTIZATION=auto
RADIANCE_MXFP4=1
RADIANCE_MXFP4_W4A8=1
RADIANCE_MXFP4_W4A8_MIN_M=0
RADIANCE_MXFP4_DECODE_MAX_M=64
RADIANCE_MXFP4_TN4_MIN_M=2048
RADIANCE_MXFP4_WPERM=1
RADIANCE_MXFP4_DECODE_NT=1
# Fast MTP
RADIANCE_QUARK_BF16_MTP=1
RADIANCE_FAST_DRAFT=1
RADIANCE_SPECULATIVE_CONFIG={"method":"mtp","num_speculative_tokens":4,"attention_backend":"R4D","disable_padded_drafter_batch":true}
# Host paths
MODELS=./models
VLLM_CACHE=./vllm-cache
WORK=.docker-compose.ymlを編集する
Served model nameを2つ指定する
筆者の場合、OpenAI互換APIから同じモデルをqwen3.8-27bとQwen3.8-27Bのどちらの名前でも受け付けたいので、2つ指定します。docker-compose.ymlを編集し、次の行を探します。
- --served-model-name=${SERVED_MODEL_NAME:-radiance-model}次の3行へ置き換えます。
- --served-model-name
- qwen3.8-27b
- Qwen3.8-27B
Thinking設定を明示する
次の行を探します。
- "--default-chat-template-kwargs={\"reasoning_effort\":\"${DEFAULT_REASONING_EFFORT:-xhigh}\"}"次の行へ置き換えます。
- '--default-chat-template-kwargs={"enable_thinking":true,"reasoning_effort":"medium","preserve_thinking":true}'thinkingを有効化し、既定の推論強度をmedium、preserve_thinkingを有効とする設定とします。
キャッシュヒットしたトークン数をレスポンスに含める(任意)
(2026/9/26 追記)
上記と同じくcommand:配下に、レスポンス内にキャッシュヒットしたトークン数を含めるオプションを追加します。
- --enable-prompt-tokens-detailsHugging Faceからモデルを取得する
モデル一式は./models/Qwen3.8-27B-Quark-AWQ-MXFP4へ配置します。
MODEL_DIR="$PWD/models/Qwen3.8-27B-Quark-AWQ-MXFP4"
mkdir -p "$MODEL_DIR"ホスト側ではダウンロード用のhfコマンドだけを使用し、torchやsafetensorsはインストール不要です。まずCLIでhfコマンドがあるかどうかを確認します。
hf --helphfがない場合は、Hugging Face8公式のスタンドアロンインストーラーを使用してインストールしてください。
curl -LsSf https://hf.co/cli/install.sh | bash必要に応じてシェルを開き直し、ダウンロード予定と空き容量を確認します。
hf download amd/Qwen3.8-27B-Quark-AWQ-MXFP4 --dry-run
df -h .後述しますが、モデルの分割中は約19.8GBの元ファイルと分割後のファイルが同時に存在することになり、合計で約40GB、それに加えてDocker用の余裕容量も必要です。問題がなければモデル一式を直接ダウンロードします。
hf download amd/Qwen3.8-27B-Quark-AWQ-MXFP4 \
  --local-dir "$MODEL_DIR"

ls -lh "$MODEL_DIR"
ls -lh "$MODEL_DIR/model.safetensors"脚注について脚注は本文の補足です。番号で切替、↩︎で戻ります。
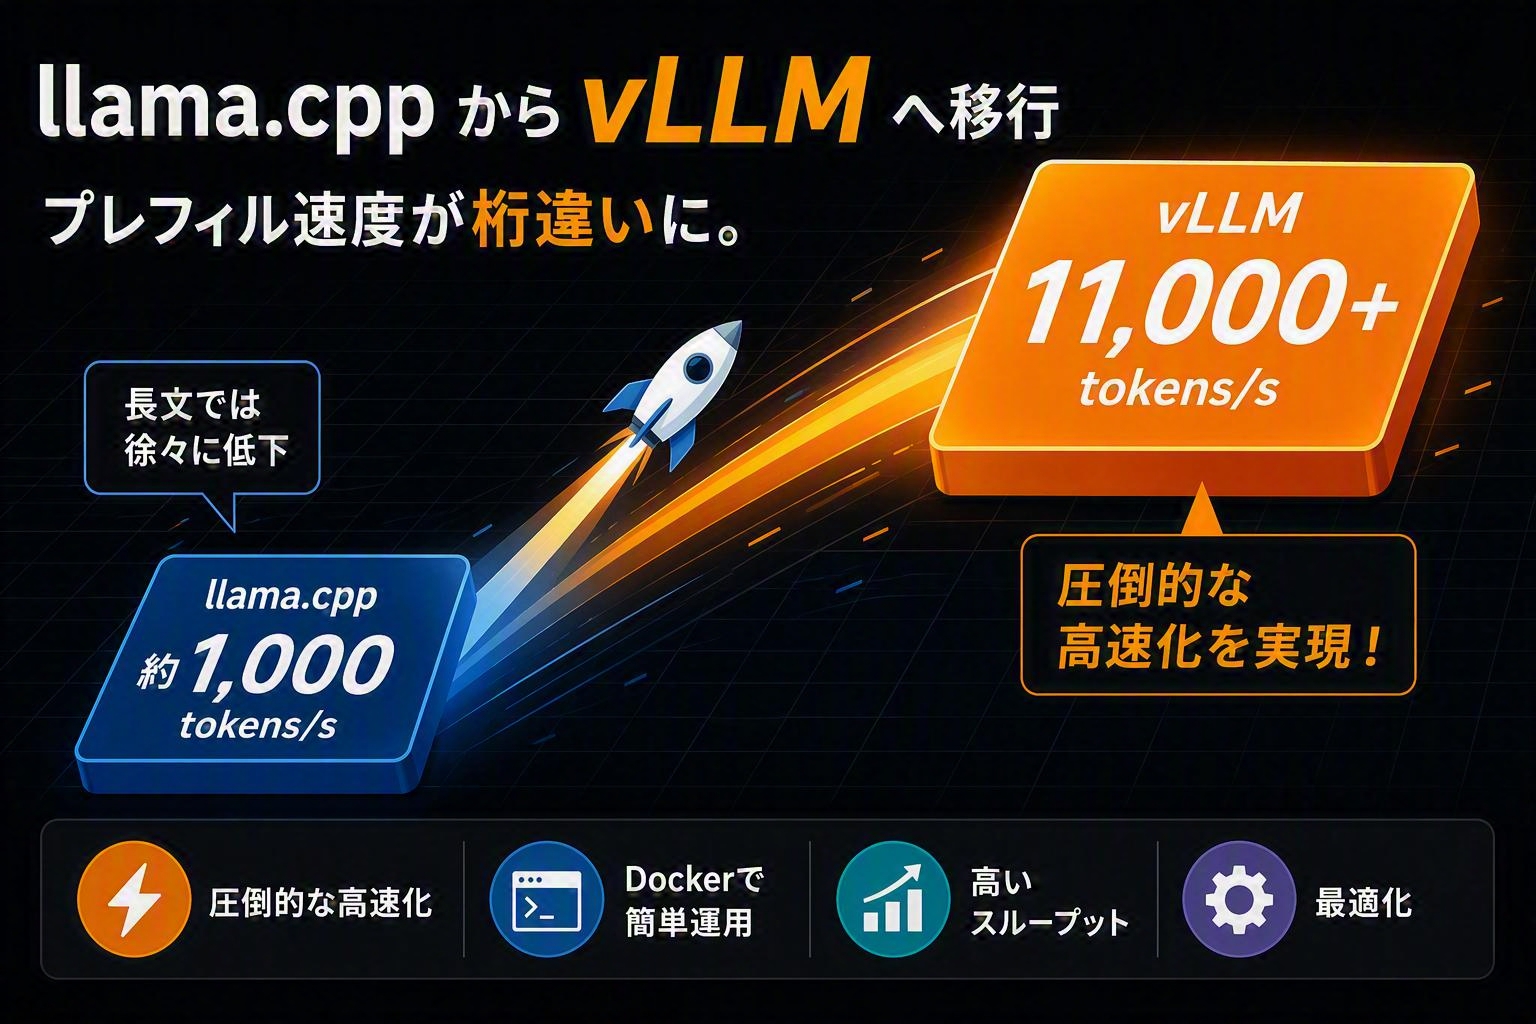
- llama.cppは、ローカル環境でLLMを動かすための軽量な推論エンジン ↩︎
- prefillは、入力した文章全体を処理し、生成に使うKVキャッシュを構築する処理。生成開始前の準備段階。PP(Prompt Processing)とも呼ばれる。また、decodeはText Generation(TG)、つまり生成フェーズを指す。 ↩︎
- t/sは1秒あたりに処理されるトークン数の単位(tokens/s)。 ↩︎
- vLLMは、LLMを高速かつ効率的に動かすための推論エンジン。フォークは、公開されたソフトウェアを派生させて独自に改良したもの ↩︎
- Dockerは、アプリケーションをコンテナと呼ばれる独立した環境で実行する仕組み。Composeは、そのコンテナの設定をファイルにまとめて管理するツール ↩︎
- MTPとDFlashは、いずれも生成を高速化する投機的デコード(speculative decoding)の方式 ↩︎
- Time to first token (TTFT)、モデルが最初のトークンを応答するまでにかかる時間 ↩︎
- Hugging Faceは、AIモデルが公開・配布されているプラットフォーム ↩︎
- ここでのカーネルは、GPU上で実行される演算プログラム。コンパイル結果はキャッシュされるため、2回目以降の起動は短縮される ↩︎