16GBメモリ環境向けにモデルを分割する
今回のマシンはホストメモリが16GBしかありません。一方、配布モデルは単一のmodel.safetensorsが約19.8GBあるため、そのまま読み込んで変換・ロードしようとするとメモリ不足になり、読み込みが終わらなくなってしまいます。そこで、モデルを約2GiBを目安に複数シャードへ分割して対処します。
まず、Radianceイメージ内で必要なPythonライブラリを利用できることを確認します。
docker compose pull vllm
docker compose run --rm \
  --no-deps \
  --entrypoint python3 \
  vllm \
  -c 'import safetensors, torch; print("safetensors and torch: OK")'
以降の分割処理もRadianceコンテナ内で実行します。
分割スクリプトを作成する
リポジトリ直下にsplit_local_model.pyを作成し、次の内容を保存します。
import json
import os
import sys

from safetensors import safe_open
from safetensors.torch import save_file


if len(sys.argv) != 2:
    raise SystemExit(f"Usage: {sys.argv[0]} MODEL_DIR")

model_dir = os.path.abspath(sys.argv[1])
src = os.path.join(model_dir, "model.safetensors")
index_path = os.path.join(model_dir, "model.safetensors.index.json")
shard_max = 2 * 1024**3

if not os.path.isfile(src):
    raise SystemExit(f"Source not found: {src}")

existing_shards = [
    name
    for name in os.listdir(model_dir)
    if name.startswith("model-") and name.endswith(".safetensors")
]
if existing_shards or os.path.exists(index_path):
    raise SystemExit(
        "Existing shards or index found. Move or remove them before splitting."
    )

with safe_open(src, framework="pt", device="cpu") as source:
    metadata = source.metadata()
    keys = list(source.keys())
    temporary_shards = []
    current = {}
    current_size = 0
    weight_map = {}

    def flush():
        global current, current_size
        if not current:
            return
        shard_number = len(temporary_shards) + 1
        temporary_name = f"model-{shard_number:05d}.safetensors"
        temporary_path = os.path.join(model_dir, temporary_name)
        save_file(current, temporary_path, metadata=metadata)
        temporary_shards.append(temporary_path)
        for key in current:
            weight_map[key] = temporary_name
        print(
            "wrote",
            temporary_name,
            f"{current_size / 1024**3:.2f} GiB",
            flush=True,
        )
        current = {}
        current_size = 0

    for key in keys:
        tensor = source.get_tensor(key)
        tensor_size = tensor.numel() * tensor.element_size()
        if current and current_size + tensor_size > shard_max:
            flush()
        current[key] = tensor
        current_size += tensor_size

    flush()

shard_count = len(temporary_shards)
renamed_weight_map = {}

for old_path in temporary_shards:
    old_name = os.path.basename(old_path)
    shard_number = int(
        old_name.removeprefix("model-").removesuffix(".safetensors")
    )
    new_name = f"model-{shard_number:05d}-of-{shard_count:05d}.safetensors"
    new_path = os.path.join(model_dir, new_name)
    os.rename(old_path, new_path)
    for key, mapped_name in weight_map.items():
        if mapped_name == old_name:
            renamed_weight_map[key] = new_name

total_size = sum(
    os.path.getsize(os.path.join(model_dir, name))
    for name in set(renamed_weight_map.values())
)
index = {
    "metadata": {"total_size": total_size},
    "weight_map": renamed_weight_map,
}

with open(index_path, "w", encoding="utf-8") as output:
    json.dump(index, output, ensure_ascii=False, indent=2)
    output.write("\n")

print(f"created {index_path}")
print("The original model.safetensors has NOT been removed yet.")
このスクリプトはテンソル単位でシャードを作成します。単一テンソルが2GiBを超える場合、そのテンソルを含むシャードも2GiBを超えますが、異常ではありません。
コンテナ内で分割を実行する
作成したスクリプトをRadianceコンテナ内で実行し、単一のmodel.safetensorsを複数のシャードへ分割します。このComposeでは、/modelsが読み取り専用でマウントされるため、この時だけ一時的に同じホストディレクトリを/models-rwとして(読み書き可能な状態で)追加マウントします。
docker compose run --rm \
  --no-deps \
  --entrypoint python3 \
  -v "$PWD/models:/models-rw:rw" \
  vllm \
  /work/split_local_model.py \
  /models-rw/Qwen3.8-27B-Quark-AWQ-MXFP4
分割結果を検証する
ls -lh "$MODEL_DIR"/model*.safetensors
ls -lh "$MODEL_DIR/model.safetensors.index.json"
インデックスと実ファイルの対応もコンテナ内で検証します。下記コマンドで検証が可能です。
docker compose run --rm \
  --no-deps \
  --entrypoint python3 \
  vllm \
  - /models/Qwen3.8-27B-Quark-AWQ-MXFP4 <<'PY'
import json
import os
import sys

model_dir = sys.argv[1]
index_path = os.path.join(model_dir, "model.safetensors.index.json")

with open(index_path, encoding="utf-8") as file:
    index = json.load(file)

shards = sorted(set(index["weight_map"].values()))
missing = [
    name
    for name in shards
    if not os.path.isfile(os.path.join(model_dir, name))
]

print("tensor entries:", len(index["weight_map"]))
print("shard count:", len(shards))
print("missing shards:", missing)

if missing:
    raise SystemExit("validation failed")
PY
期待する状態は次のとおりです。
model-00001-of-0000N.safetensors形式の分割ファイルが複数存在するmodel.safetensors.index.jsonが存在する- 検証結果に
missing shards: []と表示される
起動して動作を確認する
まず、Composeの展開結果を確認します。
docker compose config | grep -A3 -B3 'Qwen3.8-27B-Quark-AWQ-MXFP4'モデルパスが/models/Qwen3.8-27B-Quark-AWQ-MXFP4になっていればOKです。下記のコマンドで起動します。なお、初回起動時はカーネル9のコンパイルなどが走り、15~30分くらいかかりますので、気長に待ちましょう。ログも眺めておくと良いでしょう。
docker compose up -d
docker compose logs -f vllm
Application startup complete.が表示されれば、モデルのロードとAPIの起動は完了です。続いて、別のターミナルからヘルスチェックを実行します。
curl -fsS http://localhost:11434/health && echo "health check: OK"health check: OKと表示されたら、最後にOpenAI互換APIから実際に推論できることを確認します。無事に推論できれば、vLLM-Radianceの導入は成功です!
分割前のmodel.safetensorsを削除する
分割版で起動と推論の両方に成功した後は、分割元としてダウンロードした約19.8GBのmodel.safetensorsは不要になるため削除します。先に削除すると、分割や検証に失敗した際にモデルを再ダウンロードすることになるため、このタイミングで削除することとしています。
rm -- "$MODEL_DIR/model.safetensors"

test ! -e "$MODEL_DIR/model.safetensors" \
  && echo 'single-file weight removed'
まとめ
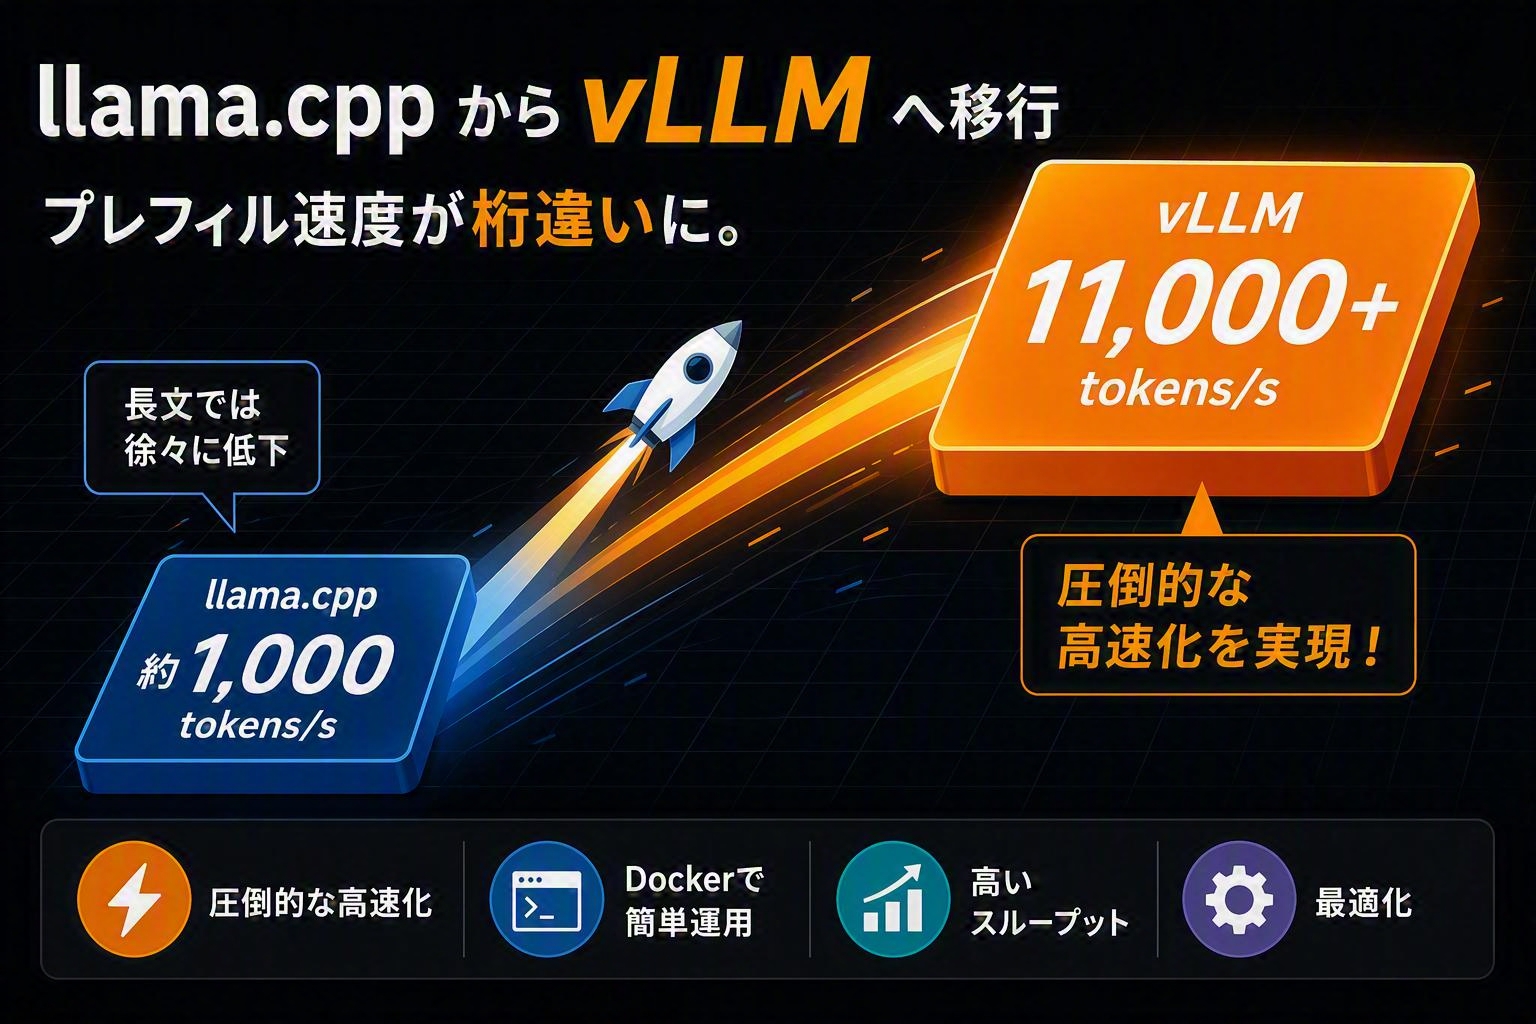
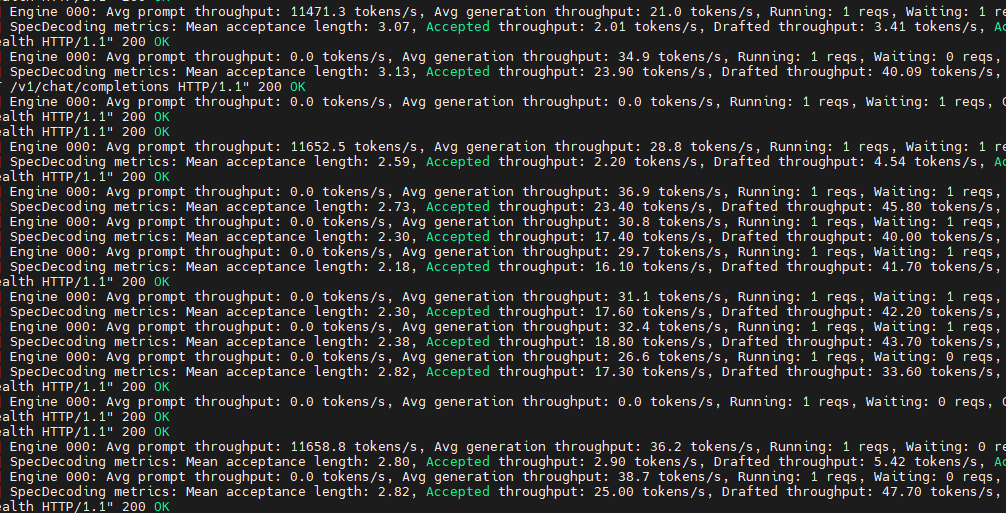
Radeon AI PRO R9700を1枚、しかもUSB4接続のeGPUとして使用する構成でも、vLLM-RadianceによってQwen3.8-27Bの推論を大幅に高速化できました。
特に大きかったのはprefillの改善で、llama.cppで課題となっていた長いコンテキストの待ち時間が解消され、約5分だったのが実用的な時間に短縮されています。
それから、16GBメモリ環境では、デカすぎる単一safetensorsの扱いがモデル読み込みのネックになっていましたが、モデルをシャード分割することで無事回避できました。同様にメモリが少ない環境でも再現しやすい設定例になっていると思います。
最後に、MTPの設定時に注意点を一つ。"disable_padded_drafter_batch":trueを入れ忘れたところGPUがハングする事態になりましたので、もしパラメータを変更する場合はご注意ください。
参考リンク
- magiccodingman/vllm-radiance:本記事で使用したvLLMフォーク
- amd/Qwen3.8-27B-Quark-AWQ-MXFP4:使用したモデルのモデルカード
- Command Line Interface (CLI) – Hugging Face:hfコマンドの公式インストール手順
- llama.cppは、ローカル環境でLLMを動かすための軽量な推論エンジン ↩︎
- prefillは、入力した文章全体を処理し、生成に使うKVキャッシュを構築する処理。生成開始前の準備段階。PP(Prompt Processing)とも呼ばれる。また、decodeはText Generation(TG)、つまり生成フェーズを指す。 ↩︎
- t/sは1秒あたりに処理されるトークン数の単位(tokens/s)。 ↩︎
- vLLMは、LLMを高速かつ効率的に動かすための推論エンジン。フォークは、公開されたソフトウェアを派生させて独自に改良したもの ↩︎
- Dockerは、アプリケーションをコンテナと呼ばれる独立した環境で実行する仕組み。Composeは、そのコンテナの設定をファイルにまとめて管理するツール ↩︎
- MTPとDFlashは、いずれも生成を高速化する投機的デコード(speculative decoding)の方式 ↩︎
- Time to first token (TTFT)、モデルが最初のトークンを応答するまでにかかる時間 ↩︎
- Hugging Faceは、AIモデルが公開・配布されているプラットフォーム ↩︎
- ここでのカーネルは、GPU上で実行される演算プログラム。コンパイル結果はキャッシュされるため、2回目以降の起動は短縮される ↩︎